С чего начать: объём видеопамяти под модель
Главный параметр — объём видеопамяти: модель должна целиком поместиться в память видеокарт, иначе часть слоёв уйдёт в оперативную память и скорость упадёт в разы. Считать просто: веса занимают около 0,5–0,6 ГБ на миллиард параметров в 4-битном квантовании и около 1 ГБ в 8-битном, сверху нужно 10–30 % на контекст. Отсюда ориентиры: 16 ГБ (RTX 5060 Ti или RTX 5070 Ti) — модели до 14B в 4 битах, Stable Diffusion XL и FLUX в FP8, обучение LoRA; 32 ГБ (2 × RTX 5060 Ti) — до 32B в 4 битах с длинным контекстом; 48 ГБ (2 × RTX PRO 4000) — до 70B в 4 битах и 32B в 8 битах; 96 ГБ (2 × RTX PRO 5000 или одна RTX PRO 6000) — 70B в 8 битах, MoE-модели вроде gpt-oss-120b целиком, генерация видео и LoRA-дообучение до 30B. Берите только NVIDIA: PyTorch, Ollama, LM Studio, vLLM и ComfyUI работают на CUDA без доработок.
Конфигурация: процессор, память, накопители, питание
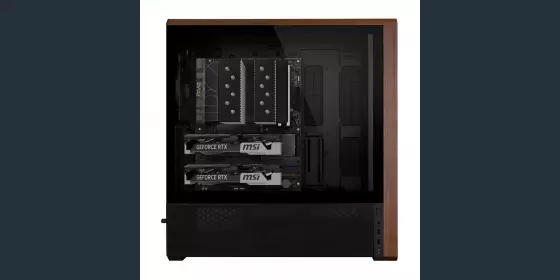
Процессор не считает модель, но готовит данные и обслуживает конвейер: важны ядра для параллельной загрузки и однопоточная производительность для Python-кода и препроцессинга. Оперативной памяти — не меньше суммарной видеопамяти: 32, 64 или 128 ГБ DDR5, иначе загрузка весов и датасетов упрётся в своп. Модели и датасеты держите на быстром NVMe: чтение весов при старте и подкачка контекста заметно выигрывают у SATA. Две видеокарты в корпусе требуют продуманного охлаждения и запаса по блоку питания — считайте суммарное потребление GPU с пиками, а не паспортные ватты. Для сервиса на десятки пользователей нужен сервер с видеокартами, для одного специалиста подойдёт настольный NVIDIA DGX Spark со 128 ГБ общей памяти.
Типичные ошибки при сборке под ИИ
Первая — экономия на видеопамяти: модель не влезает, и пользователь получает медленную работу через выгрузку слоёв вместо нормальной скорости. Вторая — мало оперативной памяти относительно видеопамяти: загрузка датасетов и препроцессинг тормозят даже при быстрых GPU. Третья — один NVMe на систему, модели и датасеты: очередь ввода-вывода бьёт по времени старта и обучения. Четвёртая — корпус и блок питания «на глаз»: две видеокарты в тесном корпусе греются и снижают частоты, а БП без запаса уходит в защиту под пиковой нагрузкой. Пятая — попытка собрать универсальную машину: под генерацию изображений и под дообучение требования к памяти и охлаждению разные, конфигурацию лучше считать под конкретный сценарий.
Что проверить перед покупкой
Сверьте с задачей три числа: объём видеопамяти с запасом на контекст, объём оперативной памяти не меньше видеопамяти и свободное место на NVMe под веса и датасеты. Уточните, какие фреймворки и квантования вы будете использовать: 4-битные схемы экономят память, но не любую модель можно квантовать без потери качества. Проверьте, что охлаждение и питание рассчитаны на длительную нагрузку, а не на короткий бенчмарк. Если планируете отдавать доступ коллегам, сразу смотрите в сторону серверных платформ и GPU-серверов: настольная станция рассчитана на одного специалиста. Инженер PORT-IT соберёт и протестирует станцию под нагрузкой, состав можно поменять под ваше ПО и бюджет, для юрлиц — счёт с НДС, доставка по России.
Вопросы и ответы
Какой компьютер нужен для работы с нейросетями?
Тот, в чью видеопамять целиком помещается ваша модель с запасом на контекст. Для моделей до 14B в 4 битах хватает 16 ГБ, для 32B — 32 ГБ, для 70B в 4 битах — 48 ГБ, для 70B в 8 битах и MoE-моделей — 96 ГБ.
Хватит ли 16 ГБ видеопамяти для Stable Diffusion и FLUX?
Да, для SDXL и FLUX в FP8 и обучения LoRA 16 ГБ достаточно. Для больших разрешений, батчей и видео генерации запас по памяти лишним не будет.
Можно ли собрать ПК для нейросетей на двух видеокартах?
Можно, и это частый вариант: 2 × RTX 5060 Ti дают 32 ГБ, 2 × RTX PRO 4000 — 48 ГБ, 2 × RTX PRO 5000 — 96 ГБ. Важно предусмотреть охлаждение, запас блока питания и достаточный объём оперативной памяти.
Сколько оперативной памяти нужно для ИИ-станции?
Не меньше суммарной видеопамяти: 32, 64 или 128 ГБ DDR5. Иначе загрузка весов и датасетов будет упираться в подкачку, и быстрые GPU не помогут.
Подойдёт ли NVIDIA DGX Spark вместо сервера?
Для одного специалиста — да: 128 ГБ общей памяти позволяют работать с крупными моделями локально. Если модель должна обслуживать десятки пользователей одновременно, нужен сервер с видеокартами.
Почему только NVIDIA, а не другие видеокарты?
PyTorch, Ollama, LM Studio, vLLM и ComfyUI рассчитаны на CUDA и работают на NVIDIA без доработок. На других платформах часть инструментов потребует обходных путей и потеряет в скорости.